
-
-
信息发布
-
门禁考勤
-
访客预约
-
会议预约
-
智慧监控
-
企业数智化
-
信息发布
-
-
公司介绍
-
企业动态
-
招标公告
-
联系我们
-
公司介绍
多模态融合算法落地,视美泰多模态语视模组赋能人机交互
大模型时代,单一的语音交互或视觉识别已难以满足产品需求,多模态融合算法正成为 AI 产品的核心竞争力。该算法可同时处理语音、人脸图像、唇形与空间方位等多维信息,带来更自然的人机对话体验,已广泛应用于 AI 数字人、服务型机器人、高端AI自助终端及 Agent 智能体设备等。

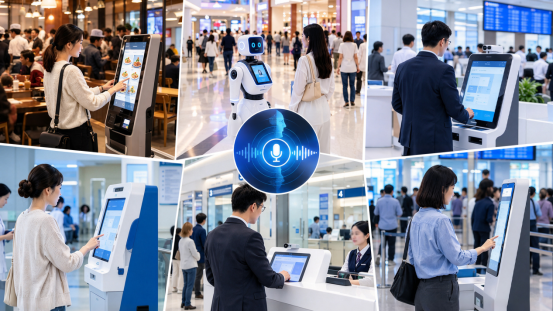
然而,多模态融合算法对硬件的音视频采集能力、算力与接口资源提出了很高要求,普通开发板难以同时承载麦克风阵列、多路摄像头输入与本地推理。针对这一痛点,视美泰推出多模态语视交互模组,可搭配 RK3572/RK3576/RK3588 主板硬件平台,同步采集音频、人脸图像、唇形特征与空间方位信号,为多模态融合算法的稳定运行提供硬件支撑。

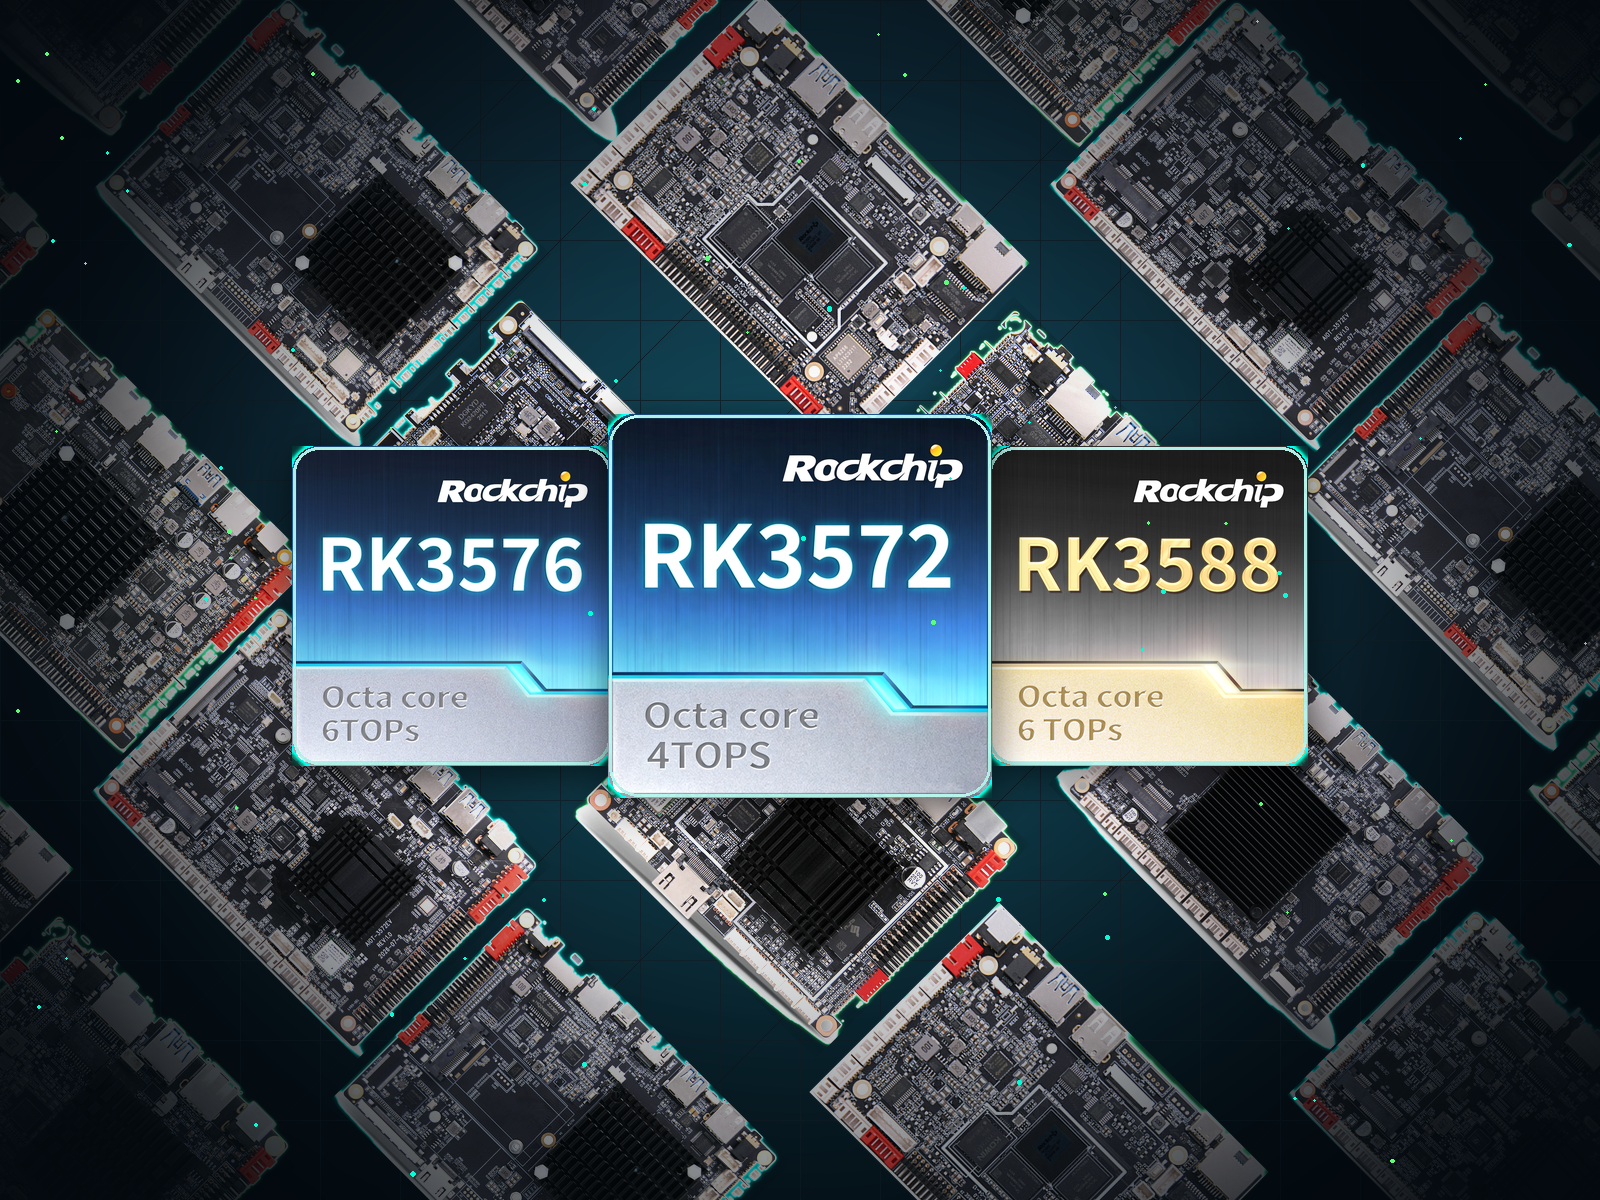
该模组在硬件层面集成麦克风阵列接口与多路 MIPI 相机接口,并结合 RK 系列 NPU 算力完成多模态融合算法的边缘端适配,使音频特征提取、唇形检测与目标追踪均可在设备本地完成,无需完全依赖云端。
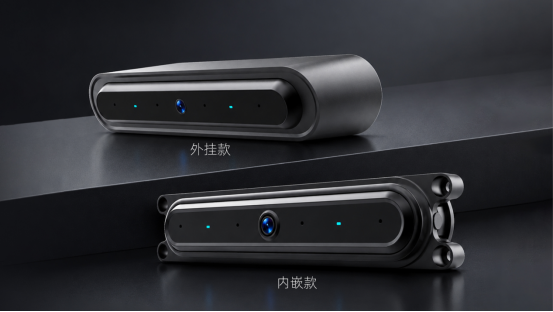


同时,视美泰提供完整的 SDK,支持开发者接入自研多模态融合算法,实现模型轻量化部署。从硬件模组、主板到整机盒子,视美泰均可提供样品打样服务,并由研发团队与 FAE 直接对接,快速响应调测问题。
创建时间:2026-11-19
넶浏览量:0

