
-
-
信息发布
-
门禁考勤
-
访客预约
-
会议预约
-
智慧监控
-
企业数智化
-
信息发布
-
-
公司介绍
-
企业动态
-
招标公告
-
联系我们
-
公司介绍
为什么多模态不是把麦克风和摄像头拼一起?拆解语视模组的三重技术逻辑
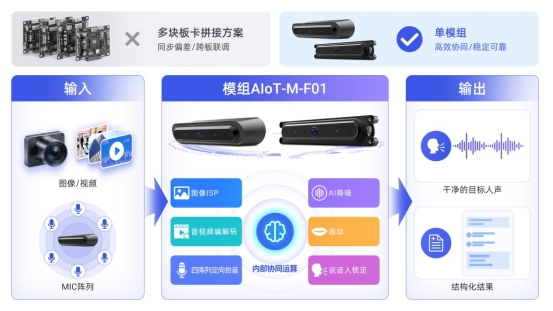
市面上宣称"多模态"的方案不少,但真正把语音与视觉做成"交叉校验"的并不多。以视美泰 AIoT-M-F01 为例,它的技术逻辑可以拆成三层。
第一层:人体检测——让设备知道"有人来了"
500 万像素单目宽动态摄像头,配合 1/2.5 英寸 CMOS 感光芯片与 F2.0 大光圈、≥75° 视场角,可在弱光、逆光等复杂光线下稳定完成人体与目标检测。
这里有一个容易被忽略的设计取向:模组只感知"有人在场",不涉及身份识别,也不留存面部信息。 用户不必担心"被认出",在海外市场也更容易符合隐私合规的期待。
一旦检测到有人进入交互范围,设备即可自动开启收声,从"被动等待唤醒"变为"主动准备接话",可支撑迎宾接待、客流统计等业务。

第二层:四阵列定向 MIC + AI 降噪——让声音先变干净
模组内置四阵列定向麦克风,有效收音距离 ≤2m,定向收音指向性偏差 ≤15°。集成全套 AI 音频算法,支持环境噪声过滤、回声抑制、人声增强。
面对餐厅、商场、医院大厅、政务大厅等高噪音场景,它优先解决的是"听不清"这个基础难题。
第三层:唇动算法——锁定到底是谁在说话
这是 AIoT-M-F01 区别于普通语音方案的关键一环。模组搭载实时唇形检测系统,通过实时画面提取唇部关键点与唇形语义信息,结合麦克风阵列的声源方位数据,通过视觉 + 音频双重维度锁定真正的说话对象。
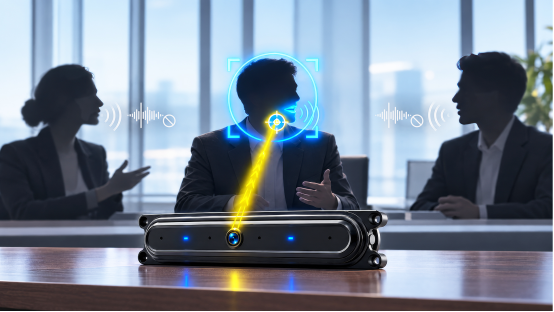
在多人交谈、背景音复杂的商用大厅与前台,它能有效避免"别人的声音触发了你的设备"这类误唤醒;即便说话人音量较低,视觉特征也可以辅助算法将目标人声从背景噪声中分离。
在语音端,模组要解决的是"从一团声音里,把目标说话人的那一句干净地取出来"——人声增强与滤波之后的音频,再结合视觉锁定的说话人信息,最终输出一路干净、连续、与画面对齐的目标人声。
交付给设备的是已经筛选过的干净音频,而不是混杂大量噪声的原始录音。 声学前端做扎实了,下游任何语音能力的识别率都会明显提升。

