
-
-
信息发布
-
门禁考勤
-
访客预约
-
会议预约
-
智慧监控
-
企业数智化
-
信息发布
-
-
公司介绍
-
企业动态
-
招标公告
-
联系我们
-
公司介绍
让机器在嘈杂世界里听懂“谁在说话” | 视美泰正式发布多模态语视模组

在餐厅、商场、政务大厅、医院、银行网点等商用嘈杂场景里,人声、广播与环境噪声交织,而真正需要被解决的交互,往往是一对一、有序发生的:顾客向点餐机点单、患者向医疗自助终端咨询、办事人向政务服务终端核对事项,都需要设备先锁定“正在和我对话的那个人”。这正是服务型机器人、数字人、点餐机、医疗服务终端、政务服务终端、商用排队终端等设备的共同刚需,也是单模态交互方案始终难以跨越的能力门槛。

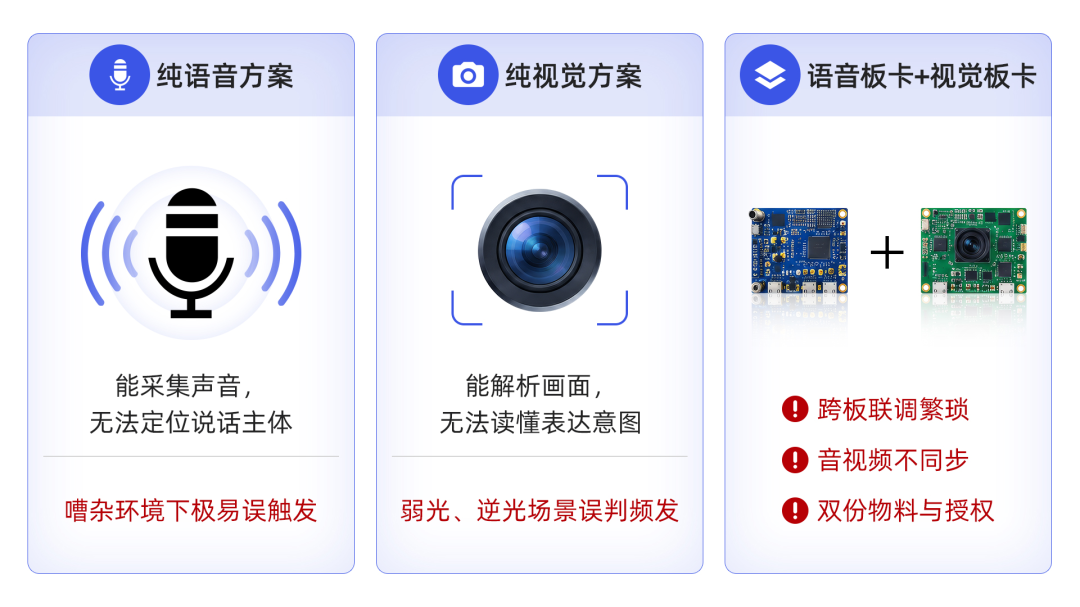
纯语音方案只能采集声音,无法定位说话主体,嘈杂环境下极易误触发;纯视觉方案仅能解析画面,无法读懂人的表达意图,弱光、逆光场景误判频发。如果分开采购语音板卡、视觉板卡组合使用,又将面临跨板联调繁琐、音视频不同步、双重物料与授权成本居高不下等现实难题。
近日,视美泰正式发布多模态语视模组 AIoT-M-F01——这是一颗把“看得见”与“听得准”合二为一的软硬件一体化模组,能在嘈杂的商用环境里锁定“正在说话的那个人”,为智能终端补上通往真实世界的交互入口。
把“看”与“听”收进一颗模组
AIoT-M-F01 的核心能力,是同时接收图像 / 视频与语音音频输入,让语音与视觉两路信息在同一套识别模型里融合校验,从嘈杂环境中锁定“正在说话的那个人”,并向设备输出干净准确的目标人声。
它把过去分布在多块板卡上的能力,收进了一颗模组之内:图像 ISP、音视频编解码、四阵列定向拾音、AI 降噪、唇动与说话人锁定,以及 USB、标准端子等外设接口,全部在单模组内部完成协同运算,规避多硬件拼接带来的同步偏差问题。

为适配不同整机的结构需求,模组提供两种形态:
-
内嵌款:可嵌入整机内部,实现设备一体化外观,适合新品整机项目开发;
-
外挂款:Type‑C 标准供电,即插即用,面向存量终端快速 AI 改造升级。
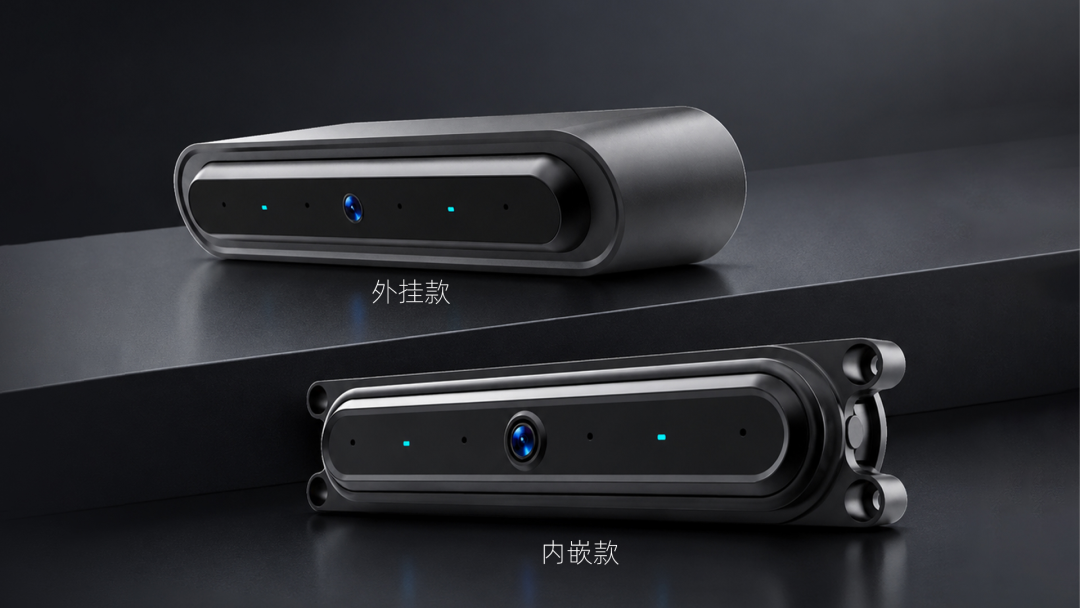
模组由主设备 5V 供电,原生适配 RK3588、RK3576、RK3572 瑞芯微硬件平台。凭借小体积、低功耗的硬件特性,存量设备加装该模组,基本无需重新修改整机供电与散热结构。
从语音到视觉的多模态融合识别
所谓“多模态”,并不是把麦克风和摄像头简单拼在一起,而是让语音与视觉两路信息在同一个识别模型里相互校验、彼此补位:语音告诉设备“说了什么、声音从哪个方向来”,视觉告诉设备“谁在动、嘴在不在动”,两条线索交叉印证,才能从一团嘈杂人声里稳定地锁定“到底是谁在说话”。这正是 AIoT-M-F01 与普通语音方案最本质的区别。
人体检测
让设备知道“有人来了”
500 万像素单目宽动态摄像头,配合 1/2.5 英寸 CMOS 感光芯片与 F2.0 大光圈、≥75°视场角,可在弱光、逆光等复杂光线下稳定完成人体与目标检测。模组只感知“有人在场”,不涉及身份识别,也不留存面部信息——用户不必担心“被认出”,在海外市场也更容易符合隐私合规的期待。一旦检测到有人进入交互范围,设备即可自动开启收声,从“被动等待唤醒”变为“主动准备接话”,可支撑迎宾接待、客流统计等业务。

四阵列定向 MIC + AI 降噪
让声音先变干净
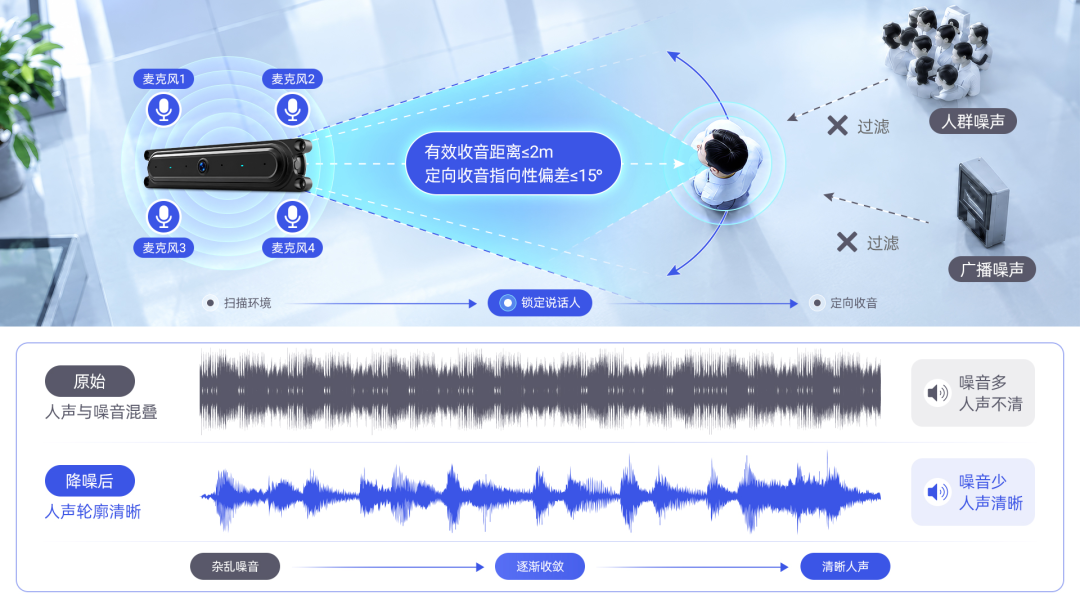
模组内置四阵列定向麦克风,有效收音距离 ≤2m,定向收音指向性偏差 ≤15°。集成全套 AI 音频算法,支持环境噪声过滤、回声抑制、人声增强。面对餐厅、商场、医院大厅、政务大厅等高噪音场景,优先解决 “听不清” 的基础难题。
唇动算法
锁定到底是谁在说话
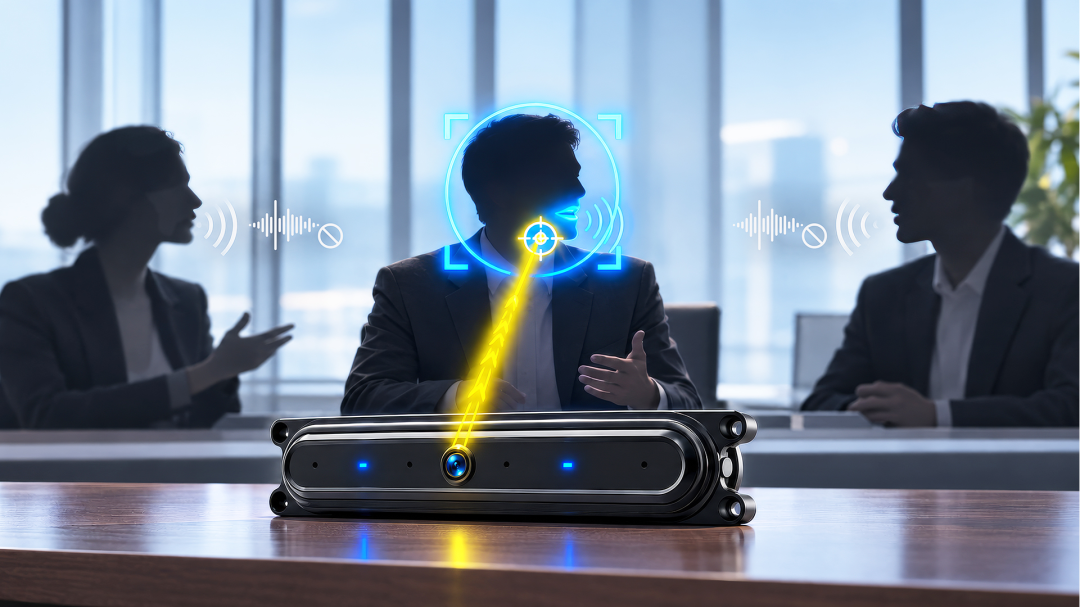
这是 AIoT-M-F01 区别于普通语音方案的关键一环。模组搭载实时唇形检测系统,通过实时画面提取唇部关键点与唇形语义信息,结合麦克风阵列的声源方位数据,通过视觉 + 音频双重维度锁定真正的说话对象。
在多人交谈、背景音复杂的商用大厅与前台,它能有效避免“别人的声音触发了你的设备”这类误唤醒;即便说话人音量较低,视觉特征也可以辅助算法将目标人声从背景噪声中分离。

目标人声提取
只把该听的那一句交出去

在语音端,模组要解决的是“从一团声音里,把目标说话人的那一句干净地取出来”:人声增强与滤波之后的音频,再结合视觉锁定的说话人信息,最终输出一路干净、连续、与画面对齐的目标人声。交付给设备的是已经筛选过的干净音频,而不是混杂大量噪声的原始录音——声学前端做扎实了,下游任何语音能力的识别率都会明显提升。
精准送音
让设备收到准确的声音
模组只做一件事:在最嘈杂的一线把声音收准,把目标说话人的人声准确、干净地交给设备,让设备收到的每一句,都是对的、都是该听的那一句。

音视双重校验
告警不再靠“猜”

传统摄像头易受树叶晃动、光影变化产生误报;纯音频方案容易被环境噪音误触发告警。AIoT-M-F01 的逻辑是:事件需要图像与音频双重特征同时匹配才触发告警。看到有人长时间停留在终端前、同时听到求助语音,才判定为需要人工介入;看到设备异常画面、同时听到设备异响,才判定为故障。这一机制可过滤大量虚警,减少人工复核工作量。
模组适合哪些设备与场景
凡是需要在嘈杂环境下准确锁定说话人的商用智能终端,都可以接入 AIoT-M-F01。以下六类场景需求最集中,它们的共同点是:环境嘈杂、交互一对一、且必须先在多人声中认准“正在说话的那个人”:
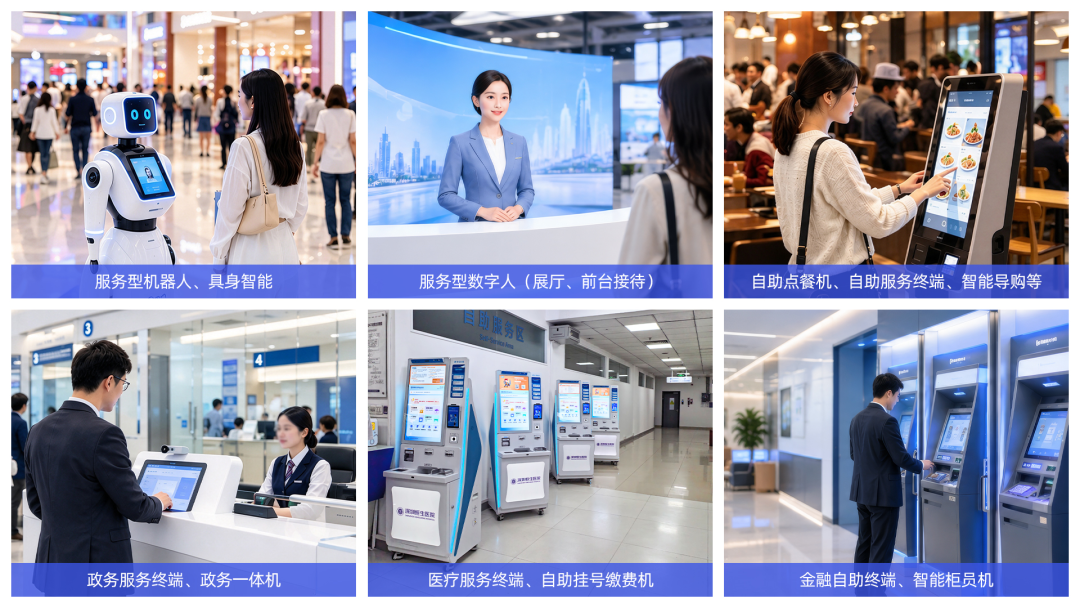
在这些场景里,AIoT-M-F01 带来的是过去难以实现的新交互:用户站在嘈杂大厅的自助终端前说话,设备只拾取他本人的声音;排队人群中旁人随口交谈,也不会误触发正在服务的终端。这种“画面 + 语音”同时校验的能力,是单模态方案做不到的。
视美泰多模态语视模组
-
交互体验升级,适配现实世界指令
支持视觉+语音联合交互;弱光、嘈杂环境交互成功率远高于纯语音或纯视觉方案,人机交互更贴合人的自然习惯。
-
算法业务效果可靠,降低误判误报
音视融合双重校验,告警虚警显著降低;不局限简单的 “检测是否有人”,同时结合画面行为与语音内容,实现事件因果关联分析,还可适配商用终端的应急呼叫、设备故障研判等高价值业务。
-
工程集成简单,缩短产品开发周期
替代语音板卡 + 视觉板卡的拼接方案,省去跨硬件联调工作;标准化接口,可快速集成至服务机器人、数字人终端、点餐机、政务与医疗自助终端等各类商用设备,不用从零开发算法硬件。
-
端侧优先,兼顾数据隐私合规
音视频原始数据可保留在设备本地,仅向外输出事件、指令等结构化结果,满足零售、政务、医疗、金融等场景的数据安全与个人隐私法规要求;同时支持端云混合部署,简单交互本地快速响应,复杂查询按需调用云端服务。
-
综合成本可控,产品生命周期可持续
虽然单模组采购单价高于普通单功能语音 / 视觉模组,但节省两套硬件物料、两套算法授权以及联调人力投入,整机 BOM 与研发综合成本更低。固件支持 OTA 在线升级多模态模型,无需更换硬件,持续拓展物体识别、事件识别等新能力,延长硬件产品生命周期,打造产品差异化卖点。
一览表

从屏幕回到对话
人机交互经历了从物理按键到多点触控的重大跃迁,如今正迎来从触控交互走向语视多模态交互的新一轮变革。当数字人与商用智能体终端大量落地门店、政务大厅、医院、银行网点和展厅,能否在嘈杂的真实环境里稳定地认清“谁在说话”、准确地拾取“该听的那一句”,正在成为判断智能设备可用性的关键标尺。
多模态语视模组AIoT-M-F01,就是为智能硬件赋予现实世界理解力的交互入口。
联系视美泰销售,了解更多产品详情!

